高性能的分析型关系数据库-DuckDB
 2024-06-06 11:28:59
 阿炯
 DuckDB 旨在实现高效的数据分析,它易于安装且运行速度非常快,并且可以在进程内 (in-process) 运行。由非盈利组织 DuckDB 基金会管理。采用C++开发并在MIT许可协议下授权。
DuckDB is a high-performance analytical database system. It is designed to be fast, reliable, portable, and easy to use. DuckDB provides a rich SQL dialect, with support far beyond basic SQL. DuckDB supports arbitrary and nested correlated subqueries, window functions, collations, complex types (arrays, structs, maps).

DuckDB 背后的核心思想是保留 SQLite 的简单性和易用性,同时通过 R/Python 和 RDBMS 之间的快速分析处理和快速数据传输进行增强,以处理 OLAP 工作负载。项目被命名为 “DuckDB”,因为创建者认为鸭子具有弹性并且可以靠任何东西为生,类似于他们设想的数据库系统运行方式。
DuckDB 项目始于 2018 年,经过近 6 年的不断打磨,至2024年已发展成为一个拥有 30 多万行 C++ 引擎代码、4.2 万次代码提交、解决了 4000 个 issue 的成熟开源项目。以其卓越的查询性能和易用性在业界赢得了广泛赞誉,GitHub 和社交媒体平台上的关注者数以万计,每月下载量高达数百万次,仅扩展模块的下载流量就超过了每天 4TB。就连维基百科也开始认可 DuckDB 的成绩。
项目团队于2025年3月发布了发展路线图,具体内容如下:
团队计划在来年开发的功能:
C extension API 的文档
Generic ODBC catalog,类似于现有的 PostgreSQL/MySQL/SQLite 集成
支持 Go 和 Rust 扩展
通过 iceberg 扩展改进了对 iceberg 格式的支持
用于模式匹配的 MATCH RECOGNIZE
使用缓冲区管理器缓存远程文件内容(例如在 S3 上查询 Parquet 文件时)。
计划在未来的某个时间点完成以下实现:
时间序列优化、分区感知优化
排序感知优化、数据库文件加密
使用自动维护的 table samples 进行更好的 Filter Cardinality Estimation
Parallel Python UDF
ALTER TABLE 支持添加外键
查询分析的改进(尤其是对于并发运行的查询)
XML 读取支持
Materialized views
MERGEstatement
支持异步 I/O
支持 PL/SQL 存储过程。
AWS 收购 DuckLabs
DuckLabs 于2026年8月下旬被 AWS 收购了,数据库界的 “MIT 许可保卫战”就此打响。
如果关注 DuckDB 的人看到这条消息第一反应是皱眉头 —— 这很正常。过去十年间,大公司收购开源团队的剧情反复上演,结局有好有坏。但这次收购的独特之处在于,DuckLabs 在宣布收购的同一篇文章里,花了大量篇幅解释 "什么不会变"。
DuckDB 会继续 MIT 许可开源,DuckDB Foundation 继续掌管项目 IP,DuckLabs 团队留在阿姆斯特丹不变,还将新增一个技术顾问委员会(technical advisory board),让社区核心成员参与技术方向决策。扩展栈也会开放,第三方签名的扩展可以在 DuckDB 中运行。
"2026年8月,我们宣布 DuckLabs 将加入 Amazon Web Services,预计 9 月初完成交割。我们的团队将继续留在阿姆斯特丹,继续在 DuckDB、DuckLake、Quack 以及更广泛的社区上工作。" 公司联合创始人 Mark Raasveldt 和 Hannes Mühleisen 在公告中写道。
这是一个谈话成本极高的收购
DuckLabs 是一家非典型的创业公司。成立五年,超过 30 人的团队,完全自筹资金(bootstrapped),创始人全资控股。"DB 圈创始人"Jordan Tigani 形容 DuckLabs"超小、聚焦、技术卓越、废话不多"。公告中创始人坦言了收购的真实驱动因素 —— 不是缺钱,是规模瓶颈。DuckDB 每日下载量已超过 100 万次,一家 30 人的自筹公司正在成为这个增长曲线的瓶颈。"我们担心 DuckLabs 的规模最终会跟不上 DuckDB 的增长。我们的小公司可能成为项目、团队和生态的瓶颈。"
更直白地说:把 DuckLabs 扩张成一家拥有销售、支持、运营部门的大公司,会把团队注意力从技术本身拉开。AWS 承诺给团队的是技术自由度和资源规模 ——"AWS 给了我们空间去专注于最关心的技术工作,同时以我们靠自己难以达到的规模运营。"
AWS 的 Andy Warfield(Distinguished Engineer, VP)在公告中表态:"在我合作过的团队中,DuckLabs 是技术最深、为人谦逊、速度最快的团队之一。"
社区的担忧:AWS 和开源项目的复杂爱情史
这个收购在 Hacker News 社区引发了激烈讨论。标题一开始是 "AWS Acquires DuckDB",HN 站长 dang 亲自改成了 "AWS Acquires DuckLabs"—— 这个修正本身就是信号。
daviewales 指出:"标题有误导性。AWS 收购的是 DuckLabs,不是 DuckDB。DuckDB 源码仍属于非营利的 DuckDB Foundation。" 技术上看这个说法没错,但社区的担忧更现实。
hobofan 的评论获得了最高赞:"在所有大公司里,亚马逊是最不擅长保持有趣技术项目活力的那家。下次重组时他们百分百会因为某个愚蠢的理由把它推平。"另一位自称在 AWS 工作了 8 年的 tokenscoper 回应:"我在 AWS 干了快 8 年,不能再同意了。"
这种担忧有前车之鉴。AWS 收购 Fig 后把它整合进了 Amazon Q,后来又变成了 Kiro CLI,"与原始产品没有任何共享功能"。MySQL 收购史也是社区反复提及的警示 ——MySQL 被 Sun 收购,Sun 被 Oracle 收购,社区分裂出 MariaDB。"Foundation 持有的项目被大公司收购核心团队" 这个剧本,社区不是第一次看了。
shimman 的评论很直接:"Foundation 的核心成员被上市公司控制,这还有什么意义?公司利益永远优先于社区利益。"
但也有不赞同的声音。jedberg 认为 AWS 在开源上做得并不差:"AWS 在开源核心技术方面相当靠谱 ——Firecracker 就是一大例子,他们还支持了 Valkey。"solidasparagus 补充了 OpenSearch,"这是亚马逊维护开放许可开源项目的一个非常好的例子"。
为什么是现在?
DuckLabs 和 AWS 的合作不是突然发生的。公告透露双方已经密切合作超过一年 —— 从 2025 年 3 月 DuckDB 宣布支持 S3 Tables 就开始了。AWS 有大量 S3 客户在使用 DuckDB,Andy Warfield 的引语也证实了这一点。与其被动应对社区分叉(想想 Redis/Valkey 和 Elasticsearch/OpenSearch),AWS 选择直接收购核心团队。DuckDB 在 "嵌入式分析数据库" 这个赛道上已经形成一个生态 —— 轻量、单进程、MIT 许可、无外部依赖。它的定位和定位决定了它不是用来取代 PostgreSQL 或 MySQL 的,而是嵌入到应用程序中作为分析引擎的。AWS 在这个领域缺乏原生产品。收购 DuckLabs 补上这个缺口,是补短板,不是重复造轮子。
Foundation 加 AWS 的组合能运转吗
Peter Boncz(CWI 数据库架构组负责人,DuckDB Foundation 理事)表示,Foundation 将继续持有 DuckDB 的所有 IP,"AWS 致力于继续推进开源 DuckDB,我预期这会加速它的创新。"
Torsten Grust(图宾根大学教授)说得更直接:"DuckDB 的开源特性、可修改性(hackability)和开发者社区把它变成了数据库研究和教学的首选平台。得知在 AWS 旗下 DuckDB 将继续开源,我很兴奋。更大的机会就在眼前。"
MotherDuck 的 CEO Jordan Tigani——DuckDB 生态中最知名的商业化公司 —— 的表态值得注意:"亚马逊把资源押在 DuckDB 背后,将为生态增加巨大动力。对我们这些相信 DuckDB 是分析领域未来平台的人来说,这是好消息。"
GitHub 上已经有开发者开始讨论 DataFusion/Apache Arrow 作为替代方案。hobofan 分析了两者的技术差距:"DataFusion 缺少索引、事务和一流的存储格式。" 短期内,DuckDB 的技术领先地位没有直接威胁。
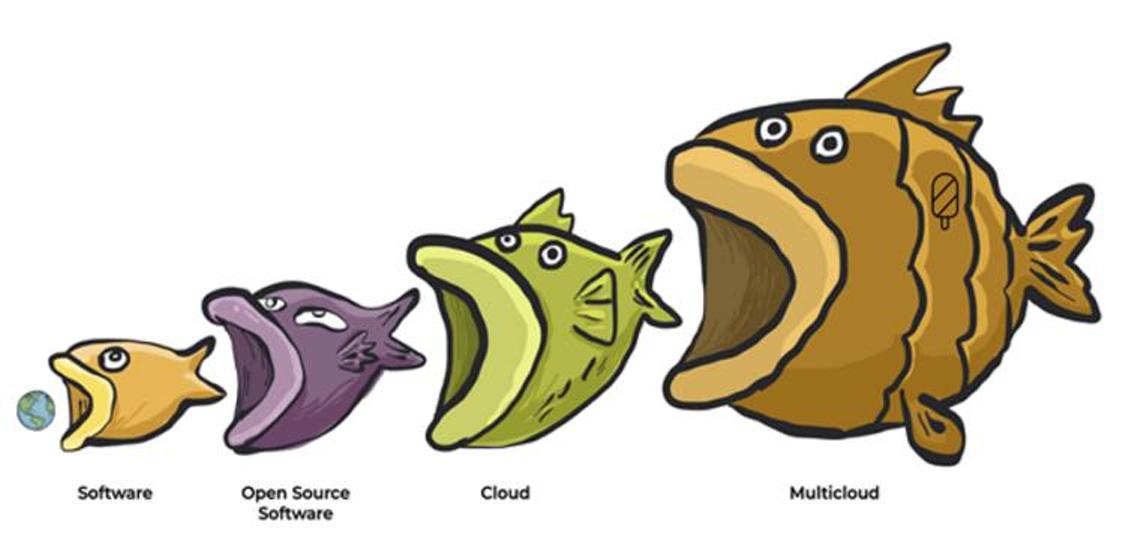
这场收购的真正故事不是 "大公司吃掉小团队",而是 "生态过于成功,创始人有意识地选择了一个能承载它继续长大的结构"。AWS 拿到了一支它想要的核心技术团队,DuckLabs 拿到了无限资源,DuckDB Foundation 还在。这个结构能不能运转,社区在看着。
最新版本:1.0
2024年6月上旬消息,v1.0.0 代号 "Snow Duck"(雪鸭),寓意着 DuckDB 在数据分析领域已经达到了一个新的高度,备受瞩目的数据分析引擎 DuckDB 迎来了一个重要的里程碑 ——1.0.0 版本正式发布。
团队意识到,数据管理系统作为应用程序的核心组件,开发者和用户之间存在着信任的契约。用户依赖数据库提供正确的查询结果并确保数据安全,而系统开发者需要意识到不能随意破坏用户应用程序的责任。
DuckDB 致力于成为人们构建应用程序的可靠基础,1.0.0 版本的发布标志着DuckDB 在存储格式稳定性、查询语义一致性等方面的重大突破,为用户提供了强有力的稳定性保证。公告写道,发布v1.0.0的主要障碍之一是存储格式 (storage format.)。DuckDB有自己的定制数据存储格式。这种格式允许用户在单个文件中管理许多(可能非常大的)表,具有完整的事务语义和最先进的压缩。但设计新的文件格式并非没有挑战,随着时间的推移,DuckDB 必须对格式进行重大更改。这导致了 DuckDB 成为次优方案,即每当发布新的DuckDB版本时,使用旧版本创建的文件无法与新的DuckDB版本配合使用,必须手动升级。
此问题在2月份的v0.10.0中得到了解决:引入了DuckDB存储格式的向后兼容性和有限的前向兼容性;团队称此功能现已使用一段时间,没有出现严重问题——他们有信心保证使用DuckDB v1.0.0创建的DuckDB文件将与未来的DuckDB版本兼容。
除了系统稳定性,v1.0.0 另一个核心方面是跨版本的稳定性。虽然永远不会破坏任何人的工作流程可能是不可能的,但他们在今后会更加谨慎地处理面向用户的变化。特别是,DuckDB计划专注于为SQL方言以及C API提供稳定性。
展望未来,DuckDB 将持续专注于系统稳定性,同时也计划丰富 DuckDB 周边的扩展环境。通过社区贡献的扩展,DuckDB 有望成为下一个数据革命的基础,为用户提供高性能的统一 SQL 接口。此外,其背后有着强大的资金支持和长期发展战略。DuckDB Labs 公司目前拥有近 20 人的核心团队,专注于 DuckDB 的长期战略发展;而非营利性的 DuckDB 基金会则确保了 DuckDB 在 MIT 开源许可下的长期发展。据称 DuckDB Labs 公司 CTO Mark 是最主力的程序员,50%的代码是他一人完成,另外还有13个程序员,1个测试实习生,1个人负责开发者生态,1个人负责培训与文档。
DuckDB v1.2.0代号为“Histrionicus”于2025年2月中旬发布。这种鸭子栖息在“北美、格陵兰、冰岛和俄罗斯东部寒冷湍急的溪流中”。v1.2.0 中的新功能、变化实在太多,无法一一详细讨论,重点介绍几个特别重要且令人兴奋的功能,下面是这些新功能的摘要和示例。
重大变化(请关注兼容性)
random函数现在更加随机。
map['entry']现在返回一个值,而不是条目列表。 例如,map(['k'], ['v'])['k']现在返回'v',而以前它返回['v']。我们还引入了map_extract_value函数,它现在是括号运算符 的别名[]。如果您想返回列表,请使用map_extract函数:map_extract(map(['k'], ['v']), 'k') = ['v']。
list_reduce的索引是固定的。在list_reduce中应用索引时,索引指向lambda 函数的最后一个参数,索引从 1 开始。因此,list_reduce(['a', 'b'], (x, y, i) -> x || y || i)返回ab2。
存储版本更新
v1.2.0 推出了新的压缩方法,但默认情况下尚未启用,以确保旧版本的 DuckDB 可以读取 DuckDB v1.2.0 生成的旧版本文件。实际上,这意味着 DuckDB v1.2.0 可以读取由过去稳定的 DuckDB 版本(例如 v1.0.0)编写的数据库文件。使用默认设置使用 DuckDB v1.2.0 时,旧版本可以读取由 DuckDB v1.2.0 编写的文件。
您可以使用以下语法选择加入较新的前向不兼容版本:
ATTACH 'file.db' (STORAGE_VERSION 'v1.2.0');
此设置指定能够读取数据库文件的最低 DuckDB 版本。使用此选项写入数据库文件时,生成的文件无法由比指定版本更早的 DuckDB 发布版本打开。它们可以由指定版本和所有较新版本的 DuckDB 读取。
如果连接到 DuckDB 数据库,则可以使用以下命令查询存储版本:
SELECT database_name, tags FROM duckdb_databases();
显示存储版本:
┌───────────────┬───────────────────────────────────┐
│ database_name │ tags │
│ varchar │ map(varchar, varchar) │
├───────────────┼───────────────────────────────────┤
│ file1 │ {storage_version=v1.2.0} │
│ file2 │ {storage_version=v1.0.0 - v1.1.3} │
│ ... │ ... │
└───────────────┴───────────────────────────────────┘
这意味着file2可以通过过去的 DuckDB 版本打开,但file1仅与(或未来版本)兼容v1.2.0。为了兼容,从新格式转换为旧格式,请在 DuckDB v1.2.0 中使用以下序列:
ATTACH 'file1.db';
ATTACH 'converted_file.db' (STORAGE_VERSION 'v1.0.0');
COPY FROM DATABASE file1 TO converted_file;
索引
ALTER TABLE ... ADD PRIMARY KEY。 经过很长一段时间,DuckDB 终于能够向现有表添加主键。因此现在可以运行此操作:
CREATE TABLE tbl(id INTEGER);
INSERT INTO tbl VALUES (42);
ALTER TABLE tbl ADD PRIMARY KEY (id);
解决了过度热切的约束检查问题。还解决了长期存在的唯一约束检查过度热切的问题。例如以下命令序列过去会引发错误,但现在可以正常工作:
CREATE TABLE students (id INTEGER PRIMARY KEY, name VARCHAR);
INSERT INTO students VALUES (1, 'John Doe');
BEGIN; -- start transaction
DELETE FROM students WHERE id = 1;
INSERT INTO students VALUES (1, 'Jane Doe');
CSV 功能
支持 Latin-1 和 UTF-16 编码。以前 DuckDB 的 CSV 读取器仅限于 UTF-8 文件。它现在可以读取 Latin-1 和 UTF-16 文件。例如:
FROM read_csv('cities-latin-1.csv', encoding = 'latin-1');
多字节分隔符。DuckDB 现在支持最多 4 个字节的分隔符。这意味着您终于可以使用鸭子表情符号作为列分隔符了。例如:
a x b
hello x world
FROM read_csv('example.dsv', sep = 'x');
严格的 CSV 解析。RFC 4180 规范 定义了格式良好的 CSV 文件的要求,例如具有单行分隔符。默认情况下,DuckDB 现在以所谓的严格模式(strict_mode = true)解析 CSV。例如,以下 CSV 文件由于混合换行符而被拒绝:
echo "a,b\r\nhello,42\nworld,84" > rfc_4180-defiant.csv
FROM read_csv('rfc_4180-defiant.csv');
Invalid Input Error:
Error when sniffing file "rfc_4180-defiant.csv".
It was not possible to automatically detect the CSV Parsing dialect/types
但它是可以用更宽松的strict_mode = false选项来解析的:
FROM read_csv('rfc_4180-defiant.csv', strict_mode = false);
┌─────────┬───────┐
│ a │ b │
│ varchar │ int64 │
├─────────┼───────┤
│ hello │ 42 │
│ world │ 84 │
└─────────┴───────┘
性能改进。新版本中的 CSV 解析器使用新算法在并行执行时查找新行。这可使速度提高约 15%。
行长不受限制。以前 DuckDB 仅限于 CSV 文件,行长不得超过 8 MB。新版本取消了此限制,行长可以是任意的。
Parquet 特性增加
Parquet 文件格式详解: 《数据库筑基课 - 列存之 Parquet》
v1.2.0 支持Parquet 字典和 Bloom 过滤器。DuckDB 现在支持使用字典编码编写更多类型。在某些情况下,这应该会减少parquet文件大小。DuckDB 现在还能够读取和写入 Parquet Bloom 过滤器。Bloom 过滤器是小型索引数据结构,可用于在设置过滤器的情况下排除行组。这对于经常重复但无序的数据(例如分类值)特别有用。
Parquet 的增量二进制压缩。DuckDB 现在支持DELTA_BINARY_PACKED压缩以及DELTA_LENGTH_BYTE_ARRAY和BYTE_STREAM_SPLIT选项。几周前,我们在一篇博客文章中详细阐述了这些内容。
CLI 改进
安全模式。DuckDB 命令行客户端现在支持安全模式,可以使用-safe标志或 点命令.safe_mode激活。在此模式下,CLI 客户端无法访问除最初连接到的数据库文件之外的外部文件,也无法与主机文件系统交互。有关更多信息,请参阅操作手册中的“保护 DuckDB”页面。更好的命令自动补全功能。CLI 中的自动完成功能现在使用解析表达式语法 (PEG)来实现更好的自动完成功能,并改进错误消息和建议。
增加大数字可读性。 如果客户端仅渲染一行,CLI 将提供打印数字的摘要。
SELECT 100_000_000 AS x, pi() * 1e9 AS y;
┌──────────────────┬───────────────────┐
│ x │ y │
│ int32 │ double │
├──────────────────┼───────────────────┤
│ 100000000 │ 3141592653.589793 │
│ (100.00 million) │ (3.14 billion) │
└──────────────────┴───────────────────┘
友好的 SQL
前缀别名。现在可以在它们所引用的内容之前指定 SQL 表达式和表别名(而不是使用众所周知的 AS 语法)。这在某些情况下可以提高可读性,例如:
SELECT
e1: some_long_and_winding_expression,
e2: t2.a_column_name
FROM
t1: long_schema.some_long_table_name,
t2: short_s.tbl;
RENAME子句。DuckDB 现在支持RENAME中的子句。这允许重命名*表达式发出的SELECT字段:
CREATE TABLE integers(col1 INT, col2 INT);
INSERT INTO integers VALUES (42, 84);
SELECT * RENAME (col1 AS new_col1) FROM integers;
* LIKE子句。SIMILAR TO和LIKE都可以作为COLUMNS列名过滤来使用。
CREATE TABLE key_val(key VARCHAR, val1 INT, val2 INT);
INSERT INTO key_val VALUES ('v', 42, 84);
SELECT * LIKE 'val%' FROM key_val;
┌───────┬───────┐
│ val1 │ val2 │
│ int32 │ int32 │
├───────┼───────┤
│ 42 │ 84 │
└───────┴───────┘
优化
在DuckDB 的优化器上投入了大量时间。很难量化优化器的改进,但这些优化的结果是,与上一版本相比,DuckDB在MacBook Pro 上运行 TPC-H SF100 查询的总运行时间提高了 13%。
扩展的 C API
目前 DuckDB 扩展使用 DuckDB 的内部 C++ 结构。这(以及一些有趣的链接问题)需要与主线 DuckDB 同步开发扩展并不断更新。从此版本开始在其中为扩展公开了一个新 C 样式 API duckdb_extension.h。此 API 可用于在 DuckDB 中创建标量、聚合或表函数。使用此 API 有两个主要优点:首先,许多编程语言(例如 Go、Rust 甚至 Java)都直接绑定到 C API,因此集成起来相当容易。其次,C 扩展 API 稳定且向后兼容,这意味着针对此 API 的扩展将继续适用于新版本的 DuckDB。我们将跟进一个新的扩展模板。
musl 扩展
分发 musl 扩展。C 库通常用于轻量级设置,例如运行 Alpine Linux 的 Docker 设置。从此版本开始,我们正式支持 musl 并为该平台分发扩展(但尚未为 分发musl)。linux_amd64_musllinux_arm64_musl
最后的想法
以上只是几个亮点,但此版本中还有更多功能和改进。自发布 v1.1.3 以来,已有 70 多位贡献者提交了超过 5,000 次提交。完整版(非常长)的发布说明可在 GitHub 上找到。再次感谢我们出色的社区使用 DuckDB、在 DuckDB 上构建出色的项目并通过向我们提供反馈来改进 DuckDB。您的贡献真的意义重大!
目前DuckDB在github已获得超26k star。
官方主页:https://duckdb.org/