ZFS文件系统
 2014-12-06 20:23:57
 阿炯
 ZFS源自于Sun Microsystems为Solaris操作系统开发的文件系统。它是一个具有高存储容量、文件系统与卷管理概念集成、崭新的磁盘逻辑结构的轻量级文件系统,同时也是一个便捷的存储池管理系统。ZFS是一个使用Common Development and Distribution License(CDDL)协议条款授权的开源项目。其命名来源发想于"Zettabyte File System"的首字母缩写。但它本身并不具备任何的缩写意涵,只是作者想阐述做为一个具备高扩充容量文件系统且还有支持许多延伸功能的一个产品。
ZFS的设计与开发由Sun公司的Jeff Bonwick所领导的一支团队完成。最早宣布于2004年9月14日,于2005年10月31日并入了Solaris开发的主干源代码。ZFS 文件系统是一种革新性的新文件系统,可从根本上改变文件系统的管理方式,并具有目前面市的其他任何文件系统所没有的功能和优点,其强健可靠、可伸缩、易于管理。是128 位文件系统。2008 年开源,目前由 OpenZFS 项目维护。
核心功能特点:
1. 文件系统(管理目录和文件)
2. 卷管理器(管理磁盘和空间)
3. 写时复制(COW)存储平台(天然支持快照和克隆)
ZFS = 文件系统 + 卷管理 + 校验和 + 快照 一体化
ZFS使用存储池的概念来管理物理存储,以前文件系统是在单个物理设备的基础上构造的。为了利用多个设备和提供数据冗余性,引入了卷管理器的概念来提供单个设备的表示,以便无需修改文件系统即可利用多个设备。此设计增加了更多复杂性,并最终阻碍了特定文件系统的继续发展,因为这类文件系统无法控制数据在虚拟卷上的物理放置。
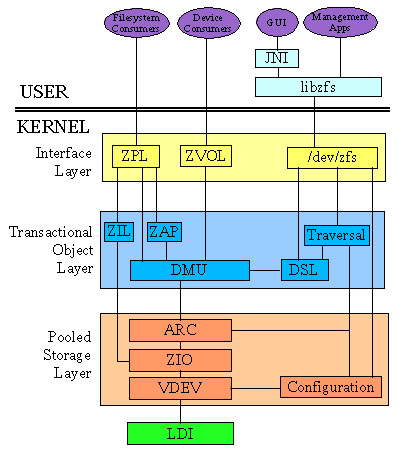
ZFS 可完全避免使用卷管理。ZFS 将设备聚集到存储池中,而不是强制要求创建虚拟卷。存储池说明了存储的物理特征(设备布局、数据冗余等),并充当可以从其创建文件系统的任意数据存储库。文件系统不再仅限于单个设备,从而可与池中的所有文件系统共享磁盘空间。您不再需要预先确定文件系统的大小,因为文件系统会在分配给存储池的磁盘空间内自动增长。添加新存储器后,无需执行其他操作,池中的所有文件系统即可立即使用所增加的磁盘空间。在许多方面,存储池与虚拟内存系统相似:将一个内存 DIMM 加入系统时,操作系统并不强迫您运行命令来配置内存并将其指定给个别进程。系统中的所有进程都会自动使用所增加的内存。
ZFS 是事务性文件系统,这意味着文件系统状态在磁盘上始终是一致的。传统文件系统可就地覆写数据,这意味着如果系统断电(例如,在分配数据块到将其链接到目录中的时间段内断电),则会使文件系统处于不一致状态。以前,此问题是通过使用fsck命令解决的。此命令负责检查并验证文件系统状态,并尝试在操作过程中修复任何不一致性。这种文件系统不一致问题曾给管理员造成巨大困扰,fsck命令并不保证能够解决所有可能的问题。最近文件系统引入了日志记录的概念。日志记录过程在单独的日志中记录操作,在系统发生崩溃时,可以安全地重放该日志。由于数据需要写入两次,因此该过程会引入不必要的开销,而且通常会导致一组新问题,例如在无法正确地重放日志时。
对于事务性文件系统,数据是使用写复制语义管理的。数据永远不会被覆写,并且任何操作序列会全部被提交或全部被忽略。因此文件系统绝对不会因意外断电或系统崩溃而被损坏。尽管最近写入的数据片段可能丢失,但是文件系统本身将始终是一致的。此外,只有在写入同步数据(使用O_DSYNC标志写入)后才返回,因此同步数据决不会丢失。
对于 ZFS,所有数据和元数据都通过用户可选择的校验和算法进行验证。提供校验和验证的传统文件系统出于卷管理层和传统文件系统设计的必要,会逐块执行此操作。在传统设计中,某些故障可能导致数据不正确但没有校验和错误,如向错误位置写入完整的块等。ZFS 校验和的存储方式可确保检测到这些故障并可以正常地从其中进行恢复。所有校验和验证与数据恢复都是在文件系统层 执行的,并且对应用程序是透明的。
此外,ZFS 还会提供自我修复数据。ZFS 支持存储池具有各种级别的数据冗余性。检测到坏的数据块时,ZFS 会从另一个冗余副本中提取正确的数据,而且会用正确的数据替换错误的数据。
ZFS 引入了一个新的数据复制模型,称为RAID-Z。它与RAID-5 类似,但采用可变条带宽度来消除RAID-5 写入漏洞(即由于数据和奇偶校验更新之间出现意外断电而导致条带损坏)。所有RAID-Z 写操作都是完整条带化写操作。这样,既没有读取-修改-写入开销,也没有写入漏洞,并且最重要的一点是不需要NVRAM硬件。ZFS 偏爱廉价磁盘。
但由于廉价磁盘容易出现故障,因此 ZFS 提供了磁盘清理功能。就像 ECC 内存清理一样,其理念是读取所有数据以检测潜在错误,而这些错误仍是可更正的。清理操作将遍历整个存储池,以读取每个块的每个副本,根据其 256 位校验和对其进行验证,并在必要时进行修复。所有这些操作都是在存储池运行和使用过程中进行的。
独一无二的可伸缩性
ZFS 文件系统的一个关键设计要素是可伸缩性。该文件系统本身是 128 位的,所允许的存储空间是 256 quadrillion zettabyte (256x1015 ZB)。所有元数据都是动态分配的,因此在首次创建时无需预先分配 inode,否则就会限制文件系统的可伸缩性。所有算法在编写时都考虑到了可伸缩性。目录最多可以包含 248(256 万亿)项,并且对于文件系统数或文件系统中可以包含的文件数不存在限制。
ZFS 快照快照是文件系统或卷的只读副本。可以快速而轻松地创建快照。最初,快照不会占用池中的任何附加磁盘空间。活动数据集中的数据更改时,快照通过继续引用旧数据来占用磁盘空间。因此快照可防止将数据释放回池中。
简化的管理最重要的是其提供了一种极度简化的管理模型。通过使用分层文件系统布局、属性继承以及自动管理挂载点和 NFS 共享语义,ZFS 可轻松创建和管理文件系统,而无需使用多个命令或编辑配置文件。可以轻松设置配额或预留空间,启用或禁用压缩,或者通过单个命令管理许多文件系统的挂载点。您就可以检查或替换设备,而无需学习另外的一套卷管理命令。您可以发送和接收文件系统快照流。
ZFS 通过分层结构管理文件系统,该分层结构允许对属性(如配额、预留空间、压缩和挂载点)进行这一简化管理。在此模型中,文件系统是中央控制点。文件系统本身的开销非常小(相当于创建一个新目录),因此鼓励您为每个用户、项目、工作区等创建一个文件系统。通过此设计,可定义细分的管理点。
存储池
不同于传统文件系统需要驻留于单独设备或者需要一个卷管理系统去使用一个以上的设备,ZFS创建在虚拟的,被称为“zpools”的存储池之上(存储池最早在AdvFS实现,并且加到后来的Btrfs)。每个存储池由若干虚拟设备(virtual devices,vdevs)组成。这些虚拟设备可以是原始磁盘,也可能是一个RAID1镜像设备,或是非标准RAID等级的多磁盘组。于是zpool上的文件系统可以使用这些虚拟设备的总存储容量。
可以使用磁盘限额以及设置磁盘预留空间来限制存储池中单个文件系统所占用的空间。
容量
ZFS是一个128位的文件系统,这意味着它能存储1800亿亿(18.4×10¹⁸)倍于当前64位文件系统的数据。ZFS的设计如此超前以至于这个极限就当前现实实际可能永远无法遇到。项目领导Bonwick曾说:“要填满一个128位的文件系统,将耗尽地球上所有存储设备。除非你拥有煮沸整个海洋的能量,不然你不可能将其填满。(Populating 128-bit file systems would exceed the quantum limits of earth-based storage. You couldn't fill a 128-bit storage pool without boiling the oceans.)”
以下是ZFS的一些理论极限:
248—任意文件系统的快照数量(2 × 10¹⁴)
248—任何单独文件系统的文件数(2 × 10¹⁴)
16 exabytes (264 byte)—文件系统最大尺寸
16 exabytes (264 byte)—最大单个文件尺寸
16 exabytes (264 byte)—最大属性大小
128 Zettabytes (278 byte)—最大zpool大小
256—单个文件的属性数量(受ZFS文件数量的约束,实际为248)
256—单个目录的文件数(受ZFS文件数量的约束,实际为248)
264—单一zpool的设备数
264—系统的zpools数量
264—单一zpool的文件系统数量
作为对这些数字的感性认识,假设每秒钟创建1,000个新文件,达到ZFS文件数极限需要大约9,000年。
写时拷贝事务模型
ZFS使用一种写时拷贝事务模型技术。所有文件系统中的块指针都包括256位的能在读时被重新校验的关于目标块的校验和。含有活动数据的块从来不被覆盖;而是分配一个新块,并把修改过的数据写在新块上。所有与该块相关的元数据块都被重新读、分配和重写。为了减少该过程的开销,多次读写更新被归纳为一个事件组,并且在必要的时候使用日志来同步写操作。
利用写时拷贝使ZFS的快照和事物功能的实现变得更简单和自然,快照功能更灵活。缺点是,COW使碎片化问题更加严重,对于顺序写生成的大文件,如果以后随机的对其中的一部分进行了更改,那么这个文件在硬盘上的物理地址就变得不再连续,未来的顺序读会变得性能比较差。
快照与克隆
ZFS使用写时拷贝技术的一个优势在于,写新数据时,包含旧数据的块被保留着,提供了一个可以被保留的文件系统的快照版本。由于ZFS在读写操作中已经存储了所有构建快照的数据,所以快照的创建非常快。而且由于任何文件的修改都是在文件系统和它的快照之间共享的,所以ZFS的快照也是空间优化的。
可写快照("克隆")也可以被创建。结果就是两个独立的文件系统共享一些列的块。当任何一个克隆版本的文件系统被改变时,新的数据块为了反映这些改变而创建,但是不管有多少克隆版本的存在,未改变的块仍然在其他的克隆版本中共享。
动态条带化
ZFS能动态条带化所有设备以最大化吞吐量。当额外的设备被加入到zpool中的时候,条带宽度会自动扩展以包含这些设备。这使得存储池中的所有磁盘都被用到,同时负载被平摊到所有的磁盘上。
可变块尺寸
ZFS使用可变大小的块,最大可至128KB。现有的代码允许管理员调整最大块大小,这在大块效果不好的时候有用。未来也许能做到自动调整适合工作量的块大小。
ZFS的可变大小的块与BtrFS和Ext4的extent不同。在ZFS中,在一个文件中所有数据块的逻辑长度必须是相同的,不同文件之间的块大小可以不同,因此ZFS可以用直接映射(direct map)的方式(同ufs/ffs/ext2/ext3)来来搜索间接块的数据指针数组(blkptr)。BtrFS和Ext4的extent方式在同一个文件中每个数据快的大小都可以不相同,因此需要用B+ Tree或者类B Tree的方式来组织间接块的数据。
虽然直接映射方式比B+ Tree的查找速度快,但是这种方式的缺点也非常明显,如:元数据开销过大、顺序IO的大文件性能不好、删除比较慢等等,因此在现代文件系统中映射方式逐渐被extent变长块取代。如果数据压缩(LZJB)被启用,可变块大小需要被用到。如果一个数据块可被压缩至一个更小的数据块,则小的数据块将使用更少的存储和提高吞吐量(代价是增加CPU压缩和解压缩的负担)。
轻量化文件系统创建
在ZFS中,存储池中文件系统的操作相比传统文件系统的卷管理更加便捷。创建ZFS文件系统或者改变一个ZFS文件系统的大小接近于传统技术中的管理目录而非管理卷。它与传统存储最大的区别:LVM 还需要一个文件系统(ext4/xfs)配合,ZFS 自己就是完整的存储栈。核心优势:数据完整性(end-to-end checksum + COW + transaction)
传统存储的痛点
传统存储 = LVM(卷管理) + ext4/xfs(文件系统) 的组合:
硬件 → 块设备 → 硬盘分区表(MBR/GPT) → 文件系统
每层独立设计、互不感知,导致:
1. 静默数据损坏(Silent Data Corruption):磁盘默默"翻转"某些位,文件系统层无法检测。ZFS 用校验和(checksum)+ Copy-on-Write 终结了这个问题
2. 写时损坏:覆盖一个文件时,意外断电可能让文件系统结构处于不一致状态。ZFS 用 事务模型(transactional)保证一致性
3. 快照机制弱:LVM 快照需要预留空间,满了就失效。ZFS 快照是原生、几乎不占空间的
4. 操作复杂:扩缩容、迁移、备份、加密……每个都要单独工具组合。ZFS 一站式解决
ZFS 解决的核心问题
| 问题 | ZFS 解法 |
| 静默数据损坏 | 端到端校验和 + 自愈(scrub) |
| 文件系统不一致 | COW + 事务 |
| 快照难用 | 原生快照,几乎无代价 |
| 数据迁移 | zfs send/recv 流式传输 |
| 容量扩张 | 在线加盘,自动 stripe |
| RAID 重建慢 | RAID-Z 分条带,避免 RAID5 write hole |
| 数据压缩 | 原生 LZ4(默认)、ZSTD、GZIP |
| 数据加密 | 原生加密(OpenZFS 2.x) |
1、端到端校验和(end-to-end Checksum)
每个数据块写入时计算 256-bit 校验和,与指针一起存储(merkle tree)。
读出时重新校验,不一致就修复(前提是有冗余副本)。
传统文件系统:写数据 → 写日志 → 写元数据(断电时可能三者不一致)
ZFS:写数据 + 校验和 → 一个原子操作(要么全成,要么全部回退)
2、Copy-on-Write(COW)
任何写操作不覆盖原数据,而是写到新位置:
文件 A 在 block 100, 200
修改 block 100:
旧:A@100, B@200
新:A'@500, B@200, [指针指向 500]
(block 100 暂时保留,可作快照用)
优势如下:
• 快照几乎瞬时
• 写时一致性保证
• 历史可回溯
3、128 位地址空间
理论上支持 256 ZB(Zettabyte) 总容量,单个 dataset 可以 16 EB。128 bit 寻址是 64 bit 的 2^64 倍——实际"足够到宇宙尽头"。
4、事务模型(Transactional)
ZFS 写数据是事务性的:要么全部写入,要么全部不写入。即使断电,文件系统也始终处于一致状态,无需 fsck。
5、RAID-Z(自愈型 RAID)
ZFS 的软件 RAID 实现:
• RAID-Z1(类似 RAID 5):1 块盘冗余
• RAID-Z2(类似 RAID 6):2 块盘冗余
• RAID-Z3:3 块盘冗余
相比 mdadm RAID5,没有 write hole 问题(COW + 元数据 transaction 解决)。
6、原生压缩
默认 LZ4,零额外延迟:
$ zfs set compression=lz4 tank/data
很多场景下 LZ4 反而提升 IOPS(CPU 压缩时间 < 磁盘读延迟)。
7、原生快照与克隆
$ zfs snapshot tank/data@before-upgrade
$ zfs clone tank/data@before-upgrade tank/data-clone
快照是只读,克隆是可写的复制品。
8、增量发送(zfs send/recv)
# 完整备份
$ zfs send tank/data@now | ssh backup zfs recv backup/data
# 增量(只发差异)
$ zfs send -i tank/data@yesterday tank/data@now | ssh backup zfs recv backup/data
这就是NAS、备份服务器的核心机制。
不擅长的场景
| 场景 | 原因 |
| 小内存 | ZFS 耗内存(推荐每 TB 存储配 1 GB ARC 缓存) |
| Linux 商业分发版(RHEL) | CDDL vs GPL 协议冲突,Red Hat 官方不推荐 |
| 跨主机共享卷 | 同一时刻只能一个客户端 mount(除非用 iSCSI/NFS 包装) |
| 数据库(OLTP) | COW 写放大,事务日志会"撕裂",MySQL/PG 慎用 |
| 极小盘 | 元数据占用 1/256 空间,最小 vdev 不建议小于 8 GB |
ZFS 与 LVM + ext4 的对比
┌──────────────────────────────────────────────────┐
│ ZFS:一体化 │
│ ┌──────────────────────────────────────┐ │
│ │ 文件系统(zfs) │ │
│ │ 卷管理(zpool) │ │
│ │ RAID(raidz1/2/3, mirror) │ │
│ │ 校验和、压缩、加密、快照 │ │
│ └──────────────────────────────────────┘ │
├──────────────────────────────────────────────────┤
│ 传统:组合 │
│ 文件系统(ext4/xfs) │
│ ↓ │
│ 卷管理(LVM) │
│ ↓ │
│ RAID(mdadm) │
│ ↓ │
│ 物理盘 │
└──────────────────────────────────────────────────┘
| 特性 | ZFS | LVM + ext4 |
| 校验和 | 端到端 | 无(硬件 ECC 依赖) |
| 写时一致性 | 事务 | 日志 + fsck |
| 快照 | 极小代价、瞬时 | 需 COW 空间 |
| 克隆 | 写时复制 | 不支持 |
| 压缩 | 原生 LZ4 | 由 FS 决定(ext4 不支持) |
| 加密 | OpenZFS 2.x | 需 LUKS |
| RAID 自愈 | scrub | 需手动介入 |
| 扩容 | 加 vdev | lvextend |
| 跨平台 | BSD/Linux 主流 | 所有 Linux |
| 学习曲线 | 较陡 | 平缓 |
| 内存需求 | 高 | 低 |
相关术语速查表
| 术语 | 含义 |
| zpool | 存储池(=LVM 的 VG) |
| vdev | 虚拟设备(pool 由若干 vdev 组成) |
| dataset | 数据集(=LVM 的 LV,自带文件系统) |
| zvol | 虚拟块设备(暴露为 /dev/zd0 给 VM 用) |
| snapshot | 快照(只读) |
| clone | 克隆(可写,从 snapshot 创建) |
| ARC | Adaptive Replacement Cache(内存级读缓存) |
| L2ARC | 二级磁盘读缓存 |
| ZIL | ZFS Intent Log(写日志,默认在 pool) |
| SLOG | Separate ZIL(独立设备上的 ZIL) |
| scrub | 校验+修复扫描 |
| resilver | 替换盘后重建数据 |
| merkle tree | 校验和的树形结构 |
| ashift | 物理盘扇区对齐参数(2^ashift 字节) |
| recordsize | 默认 128 KB,可调 |
| copies | 同一数据保存几份(1/2/3) |
小结:Sun的开源ZFS文件系统十大最佳功能
Sun的开源ZFS文件系统拥有几个非常好的功能。它最初是针对Solaris设计的,于2005年问世,但是你也会在OpenSolaris和相关发行版本中发现它的踪影。未来它也有可能成为运行在Linux和BSD上一个受人们欢迎的文件系统。以下是ZFS支持者认为ZFS具备的十大最佳功能特性:
1、元数据校验和确保数据完整性
数据完整性在ZFS中具有非常高的重要性,也是很多ZFS功能的前决条件。它采用了256位校验和,当向磁盘写入数据的时候,校验和就会被作为元数据与它相关的数据分开保存。与普通的磁盘块校验和不同的 是,这种校验和可以检测出错位写、误读取和误写入、DMA奇偶错误、驱动器bug、意外过量写入以及常见的物理存储的衰减(bit rot)。
2、写时才拷贝
ZFS文件系统是使用多项技术来确保数据在磁盘上的连续性,其中就包括写时才拷贝(Copy on Write),也就是当数据发生变更的时候它并不会过量写入——它总是在指针指向变更数据之前被写入到一个新块和校验和中。旧的数据可能被保存下来,在发 生变更的过程中创建文件系统的快照。利用ZFS的文件写入是交易型的操作——要么将所有数据写入到磁盘,要么什么都不写入。
3、利用Time Slider的数据快照
OpenSolaris的最新版本展示了ZFS利用TimeSlider小型图形应用所实现的强大快照功能。可以通过配置设定对ZFS文件系统进行常规的快照操作——每15分钟,或者每小时等等。这种快照占用容量很小,而且很高效,因为它只保存与之前快照的变量。
TimeSlider提供了对文件系统(或者一个家庭文件夹)的查看功能,而且有一个可以沿着时间线返回到更早快照时间的滑块。当这些完成之后 就会呈现特定快照时间的文件系统或者文件夹内容。如果想要恢复一份被错误过量写入的文件,或者在升级失败之后还原系统的话,你只需要将滑块滚回合适的快照 时间就可以了。
4、数据存储池
ZFS利用可用的存储驱动器将他们聚合成为一个被称为zpool的资源池。这个资源池可以使用脚本、镜像或者某种RAID针对容量、I/O性能 或者冗余性进行优化。如果需要更多存储的话,只需要向zpool中添加更多存储就行了——ZFS检测到新添加的容量并开始自动使用、均衡I/O和最大限度 提高吞吐量。
5、RAIDZ和RAIDZ2
众所周知,RAID 5有一个重大缺陷——RAID5 Write Hole。RAID 5在写数据的时候,是分为两步的,首先将数据写到磁盘阵列上,然后将该stripe上数据的校验码记录到阵列上,如果在刚写完数据的时候,系统断电,那么该数据对应的校验码就没有机会再恢复了。如果接下来磁盘发生故障,RAID重建流程就会出现错误数据。唯一的解决方案就是,如果整个stripe发生过量 写入,那么就会生成一个正确的奇偶块。
RAIDZ通过使用一个不同宽度的条带来解决这个问题,这样每次写入实际上是一个完全的条带写入。再加上ZFS的写入时才拷贝特性,这些就完全消除了RAID 5的Write Hole缺陷。RAIDZ2也是同理,但是可以使用双奇偶允许阵列中丢失两个磁盘。安装一个RAIDZ(或者RAIDZ2)阵列非常简单,只需要发布一条命令。
6、固态盘混合存储池
存储池中可以通过添加高性能固态盘变成一个混合存储池。当这些固态盘被作为高性能缓存磁盘的时候,ZFS就会用其保留频繁访问数据以提高性能。另外ZFS还采用了L2 ARC技术来写入那些不需要立即保存的数据,在时间和资源允许的情况下,这些数据会被慢慢迁移到传统的更永久性的硬盘驱动器中。
7、容量
ZFS是128位的文件系统,也就是说理论上它可以保存256千万亿ZB(1ZB=10亿TB)。实际中,它的容量远远超过所需范围,至少就可预见未来来说。
8、数据清理
ZFS可以清理一个存储池中的所有数据,根据相应的校验和检查每个数据来验证其完整性,检测任何潜在的数据损毁,修复可能存在的任何错误。
当数据被冗余保存起来的时候——保存在镜像或者RAID型阵列中——它可以修复检测出任何潜在的损坏数据,而且无需管理员的干预。因为数据损坏是被记录下来的,所以ZFS可以通过导致数据不恰当保存在硬盘中的内存模块(或者其他硬件)检测出来。
数据清理的I/O优先级是很低的,因此这个流程对系统性能的影响非常小。
9、简单且有效的管理
使用ZFS命令,就相当于你使用了一种简短而有效的命令来管理系统。例如,一个5磁盘RAIDZ阵列可以设置采用单命令:
zpool create poolname raidz c1t0d0 c2t0d0 c3t0d0 c4t0d0 c5t0d0
10、更多期待
ZFS仍在不断更新完善,不时增加新的功能。ZFS的2009年路线图中包括用于提高安全性的加密功能以及提高存储效率的重复数据删除功能。
如果对尝试使用ZFS感兴趣的话,最简单的方法就是下载OpenSolaris或者相关发行版本。
参考链接
ZFS主页
Solaris ZFS 管理指南